메모리 할당 방식
본 포스트는 인프런 “[CS 기술면접 2] 말이 트이는 운영체제” 강의를 학습하며 정리한 내용을 다룹니다.
1. 메모리 할당 방식
운영체제는 실행 중인 프로그램을 메모리에 적재하고, 각 프로그램이 사용할 메모리 공간을 관리합니다.
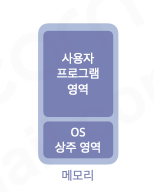
일반적인 메모리 구조를 단순화하면 낮은 주소 영역에는 운영체제 커널이 위치하고, 높은 주소 영역에는 사용자 프로그램이 적재되는 형태로 표현할 수 있습니다.
- 낮은 주소 영역: 운영체제(OS) 커널이 상주하는 공간
- 높은 주소 영역: 사용자 프로그램이 적재되는 공간
- 메모리 할당 방식: 프로그램을 물리 메모리에 배치하는 방법에 따라 연속 할당과 불연속 할당으로 구분
연속 할당(Contiguous Allocation)
연속 할당은 프로세스가 사용하는 메모리 공간을 물리 메모리의 연속된 영역에 할당하는 방식입니다.
프로그램이 메모리에 적재될 때 하나의 연속된 공간을 사용하며, 해당 영역은 다른 프로세스와 구분하여 관리됩니다.
- 연속 할당: 프로그램이 메모리에 적재될 때 하나의 연속된 공간에 배치
- 불연속 할당: 프로그램을 여러 부분으로 나누어 물리 메모리의 서로 떨어진 공간에 배치
- 메모리 사용: 하나의 프로세스가 할당받은 연속된 물리 메모리 영역을 독립적으로 사용
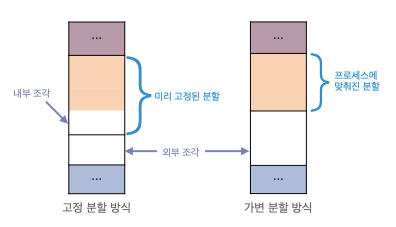
고정 분할 방식(Fixed Partitioning)
- 메모리를 미리 정해진 크기의 여러 영역으로 나누어 프로그램에 할당
- 각 분할 영역의 크기는 서로 다르게 설정 가능
- 할당된 분할 영역에 사용하지 않는 공간이 남는 내부 단편화 발생 가능
- 사용 가능한 분할 영역의 크기와 배치에 따라 메모리 활용에 제약 발생 가능
가변 분할 방식(Variable Partitioning)
- 프로그램의 크기에 따라 메모리 분할 영역의 크기와 개수를 동적으로 조정
- 프로그램에 필요한 크기만큼 공간을 할당하여 내부 단편화 최소화
- 메모리 할당과 해제가 반복되면서 외부 단편화 발생 가능
내부 단편화와 외부 단편화
- 내부 단편화(Internal Fragmentation): 할당된 메모리 영역 안에서 실제로 사용하지 않고 남는 공간
- 외부 단편화(External Fragmentation): 사용 가능한 메모리 공간이 여러 곳에 흩어져 있어, 전체 빈 공간의 크기는 충분하지만 필요한 크기의 연속된 공간을 확보하지 못하는 현상
프로그램을 적재할 메모리 공간 선택 알고리즘
연속 할당에서는 프로그램을 적재할 수 있는 빈 메모리 공간이 여러 곳에 존재할 수 있습니다. 운영체제는 이러한 공간 중 어디에 프로그램을 배치할지 결정해야 합니다.
대표적인 공간 선택 알고리즘으로 First-Fit, Best-Fit, Worst-Fit이 있습니다.
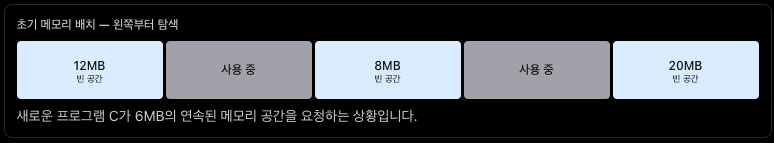
다음과 같이 빈 메모리 공간이 존재한다고 가정하겠습니다.
First-Fit(최초 적합)
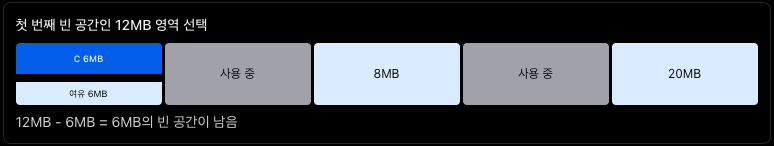
- 메모리를 처음부터 탐색하여 프로그램이 들어갈 수 있는 첫 번째 빈 공간에 할당
Best-Fit(최적 적합)
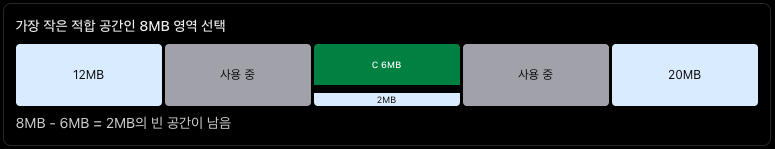
- 프로그램이 들어갈 수 있는 빈 공간 중 크기가 가장 작은 공간에 할당
Worst-Fit(최악 적합)
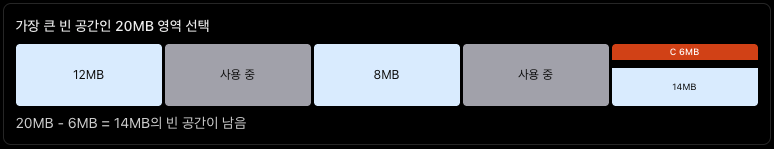
- 프로그램이 들어갈 수 있는 빈 공간 중 크기가 가장 큰 공간에 할당
세 알고리즘은 모두 새로운 프로그램에 필요한 메모리 크기를 기준으로 빈 공간을 선택하지만, 어떤 공간을 우선적으로 선택하는지에 차이가 있습니다.
| 알고리즘 | 선택 기준 | 할당 후 남는 공간 |
|---|---|---|
| First-Fit | 처음 발견한 적합한 공간 | 6MB |
| Best-Fit | 가장 작은 적합한 공간 | 2MB |
| Worst-Fit | 가장 큰 적합한 공간 | 14MB |
2. 불연속 할당(Non-contiguous Allocation)
불연속 할당은 프로세스를 여러 부분으로 나누어 물리 메모리의 서로 떨어진 공간에 배치하는 방식입니다.
연속 할당처럼 하나의 큰 메모리 영역을 확보할 필요가 없으며, 물리 메모리에 분산된 빈 공간을 활용할 수 있습니다.
- 페이징(Paging): 프로그램을 고정된 크기의 페이지로 분할하여 메모리에 할당
- 세그멘테이션(Segmentation): 프로그램의 논리적인 구성 단위를 기준으로 가변 크기의 세그먼트로 분할하여 할당
- 페이지드 세그멘테이션(Paged Segmentation): 세그멘테이션과 페이징을 결합한 메모리 관리 방식
페이징(Paging)
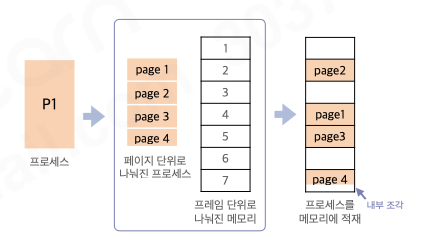
페이징은 프로세스의 논리 주소 공간을 일정한 크기의 페이지로 나누고, 이를 물리 메모리의 프레임에 배치하는 방식입니다.
프로세스의 페이지들을 물리 메모리에 연속적으로 배치할 필요가 없으므로, 분산된 빈 프레임을 활용할 수 있습니다.
- 프로세스의 논리 주소 공간을 고정된 크기의 페이지로 분할
- 물리 메모리를 페이지와 동일한 크기의 프레임으로 분할
- 각 페이지를 물리 메모리의 빈 프레임에 할당
- 페이지를 연속된 물리 메모리 공간에 배치할 필요 없이 빈 프레임을 활용
페이지 관련 용어
- 페이지(Page): 프로세스의 논리 주소 공간을 일정한 크기로 나눈 단위
- 프레임(Frame): 물리 메모리를 페이지와 동일한 크기로 나눈 단위
- 페이지 테이블(Page Table)
- 프로세스의 페이지 번호와 물리 메모리의 프레임 번호 간 매핑 정보를 저장
- 각 페이지가 실제 물리 메모리의 어느 프레임에 저장되어 있는지 관리
- 페이지가 물리 메모리에 순서대로 적재되지 않더라도 해당 페이지의 위치를 확인할 수 있도록 지원
페이지 테이블을 이용한 주소 변환
CPU가 사용하는 논리 주소는 페이지 번호(p)와 페이지 오프셋(d)으로 나뉩니다.
- 페이지 번호(p): 논리 주소가 속한 페이지를 식별하는 번호
- 페이지 오프셋(d): 해당 페이지 내부에서 접근하려는 위치를 나타내는 값
- 변위(Displacement): 기준점으로부터 얼마나 떨어져 있는지를 나타내는 거리 또는 위치 차이
- 프레임 번호(f): 페이지 테이블에서 페이지 번호(p)에 대응하여 얻는 물리 메모리의 프레임 번호
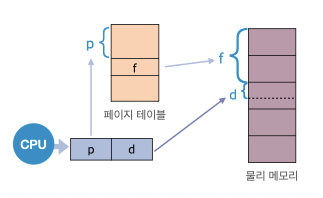
주소 변환 과정은 다음과 같습니다.
- CPU가 생성한 논리 주소를 페이지 번호(p)와 오프셋(d)으로 분리합니다.
- 페이지 번호(p)를 페이지 테이블의 인덱스로 사용하여 해당 페이지에 매핑된 프레임 번호(f)를 확인합니다.
- 프레임 번호(f)를 바탕으로 실제 물리 메모리의 프레임 시작 주소를 계산합니다.
- 프레임 시작 주소에 오프셋(d)을 더하여 최종 물리 주소를 얻습니다.
여기서 페이지 번호(p)와 프레임 번호(f)는 서로 다른 값입니다. 페이지 번호는 논리 주소 공간에서의 위치를 나타내고, 프레임 번호는 실제 물리 메모리에서의 위치를 나타냅니다.
페이지 테이블의 구현
페이지 테이블은 일반적으로 물리 메모리에 저장되며, 운영체제는 페이지 테이블의 위치와 크기를 관리하기 위해 레지스터를 사용합니다.
페이지 테이블 베이스 레지스터(PTBR: Page Table Base Register)
- 기능: 현재 실행 중인 프로세스의 페이지 테이블 시작 주소를 저장
- 역할: CPU가 페이지 테이블에 접근할 수 있도록 기준 주소 제공
페이지 테이블 길이 레지스터(PTLR: Page Table Length Register)
- 기능: 페이지 테이블의 엔트리 개수 또는 길이를 저장
- 역할: 유효하지 않은 페이지 번호로 페이지 테이블에 접근하는 것을 방지
- 예시: 페이지 번호가 PTLR에 저장된 엔트리 개수 이상이면 잘못된 참조로 처리
PTBR과 PTLR을 이용한 주소 변환 과정
- CPU가 페이지 번호(p)와 오프셋(d)으로 구성된 논리 주소를 생성합니다.
- PTLR을 통해 페이지 번호가 유효한 범위에 있는지 확인합니다.
- PTBR을 통해 현재 프로세스의 페이지 테이블 시작 주소를 확인합니다.
- 페이지 번호(p)를 인덱스로 사용하여 페이지 테이블의 해당 엔트리를 조회합니다.
- 페이지 테이블에서 확인한 프레임 번호와 오프셋을 이용해 물리 주소로 변환합니다.
- 변환된 물리 주소에 접근합니다.
TLB(Translation Lookaside Buffer)
TLB는 페이지 테이블의 주소 변환 정보를 캐싱하는 고속 메모리입니다.
페이징 방식에서는 논리 주소를 물리 주소로 변환하기 위해 페이지 테이블에 접근해야 합니다. 이 과정에서 발생하는 메모리 접근 시간을 줄이기 위해 TLB를 사용합니다.
- 페이지 번호와 프레임 번호 간 매핑 정보를 캐싱
- 최근 사용되거나 자주 참조되는 주소 변환 정보를 저장
- 페이지 테이블에 접근하는 횟수를 줄여 주소 변환 속도 향상
TLB 동작 과정
- TLB 히트(TLB Hit)
- TLB에 요청한 페이지 번호의 매핑 정보가 존재하는 상태
- 페이지 테이블에 별도로 접근하지 않고 TLB에서 프레임 번호 확인
- 확인한 프레임 번호와 오프셋을 사용하여 물리 주소로 변환
- TLB 미스(TLB Miss)
- TLB에 요청한 페이지 번호의 매핑 정보가 존재하지 않는 상태
- 페이지 테이블에 접근하여 해당 페이지에 매핑된 프레임 번호 확인
- 확인한 주소 변환 정보를 TLB에 저장하여 이후 접근 속도 향상
- 프레임 번호와 오프셋을 사용하여 물리 주소로 변환
3. 세그멘테이션(Segmentation)
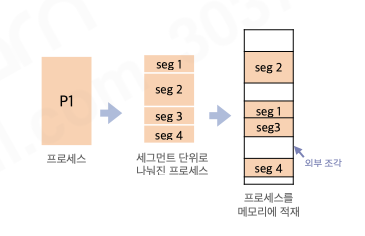
세그멘테이션은 프로그램을 논리적인 구성 단위인 세그먼트(Segment)로 나누어 메모리에 할당하는 방식입니다.
페이징은 모든 페이지를 동일한 크기로 분할하지만, 세그멘테이션은 프로그램의 코드, 데이터, 스택과 같은 논리적인 구조를 기준으로 서로 다른 크기의 세그먼트로 분할합니다.
- 논리적 분할: 프로그램의 코드, 데이터, 스택 등 논리적인 구성 단위에 따라 메모리 분할
- 가변 크기: 각 세그먼트의 크기가 고정되지 않고 실제 필요한 크기에 따라 달라지는 구조
세그멘테이션 관련 용어
- 세그먼트(Segment): 프로그램을 구성하는 코드, 데이터, 스택 등의 논리적인 단위
- 세그먼트 번호(s): 각 세그먼트를 식별하는 번호
- 오프셋(d): 해당 세그먼트 내에서 접근하려는 위치를 나타내는 값
세그먼트 테이블 구조
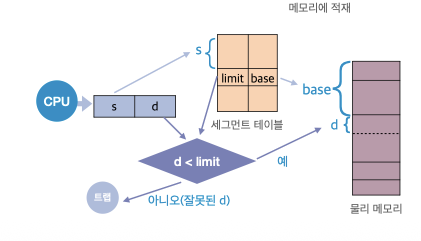
세그먼테이션에서는 각 세그먼트의 물리 메모리 위치와 크기를 관리하기 위해 세그먼트 테이블을 사용합니다. 세그먼트 테이블의 각 엔트리는 기준 주소(Base)와 한계(Limit) 정보를 포함합니다.
- 기준(Base): 해당 세그먼트가 물리 메모리에서 시작하는 주소
- 한계(Limit): 해당 세그먼트에 할당된 메모리 크기
- 페이징은 모든 페이지의 크기가 동일하지만 세그멘테이션은 세그먼트마다 크기가 서로 다르므로 각 세그먼트의 크기를 나타내는 한계 값이 필요
CPU가 생성한 논리 주소는 세그먼트 번호(s)와 오프셋(d)으로 구성됩니다.
세그먼트 번호를 이용해 세그먼트 테이블의 해당 엔트리를 조회하고, 오프셋이 세그먼트의 한계 범위 내에 있는지 검사합니다. 유효한 접근이라면 세그먼트의 기준 주소에 오프셋을 더하여 물리 주소를 계산합니다.
장점
- 프로그램의 코드, 데이터, 스택 등을 논리적인 단위로 구분하여 관리
- 세그먼트마다 필요한 크기의 메모리를 할당하여 내부 단편화로 인한 메모리 낭비 감소
단점
- 외부 단편화 발생 가능
- 세그먼트 크기가 가변적이므로 메모리 할당과 해제 과정에서 작은 빈 공간이 여러 곳에 발생 가능
- 주소 변환 오버헤드
- 세그먼트 테이블을 조회하고 접근 범위를 검사하는 과정에서 추가적인 처리 시간 소요