프로세스와 스레드
본 포스트는 인프런 “[CS 기술면접 2] 말이 트이는 운영체제” 강의를 학습하며 정리한 내용을 다룹니다.
프로세스(Process)란?
프로세스(Process)는 실행 중인 프로그램을 의미합니다.
예를 들어 컴퓨터에 게임을 설치하면 실행 파일이 디스크에 저장됩니다. 이 상태에서는 단순히 프로그램이 저장되어 있을 뿐이지만, 게임을 실행하면 운영체제가 프로세스를 생성하고 실행에 필요한 메모리와 자원을 할당합니다.
프로세스의 주소 공간
프로세스는 실행 중에 사용하는 독립적인 주소 공간을 가지고 있습니다. 일반적으로 다른 프로세스와 주소 공간을 공유하지 않으며, 이 공간은 크게 네 가지 영역으로 구분됩니다.
- 코드(Code): 프로그램의 실행 코드가 저장되는 영역
- 데이터(Data): 초기화된 전역 변수와 정적 변수가 저장되는 영역
- 힙(Heap): 동적으로 할당되는 메모리가 저장되는 영역
- 스택(Stack): 함수 호출 시 사용되는 지역 변수, 매개변수 등이 저장되는 영역
프로세스 문맥(Context)
CPU는 여러 프로세스를 번갈아 실행합니다. 이때 프로그램 A를 실행하다가 프로그램 B로 전환하고, 나중에 다시 프로그램 A를 실행하려면 이전에 어디까지 작업했는지 기억해야 합니다.
이처럼 프로세스가 실행되는 동안 CPU와 운영체제가 관리해야 하는 상태 정보를 프로세스 문맥(Process Context)**이라고 합니다.
프로세스 문맥을 구성하는 주요 정보는 다음과 같습니다.
- CPU 레지스터
- CPU가 명령어를 실행하는 동안 사용하는 데이터 저장소
- 예: 프로그램 카운터(PC), 각종 CPU 레지스터
- 프로세스 제어 블록(PCB)
- 운영체제가 프로세스의 정보를 저장하는 자료구조
- 프로세스 ID, 우선순위, 스케줄링 정보 등을 포함
- 메모리 관련 정보
- 프로세스가 사용하는 메모리 위치와 페이지 테이블 정보 등을 포함
- 예: 코드, 데이터, 힙, 스택 등의 주소 공간 정보
- 열린 파일과 장치 정보
- 프로세스가 사용 중인 파일이나 디바이스의 상태 정보
- 예: 열려 있는 파일의 디스크 위치
이러한 정보가 있어야 CPU가 다른 프로세스를 실행하다가 돌아오더라도 이전 작업을 이어서 수행할 수 있습니다.
프로세스 상태
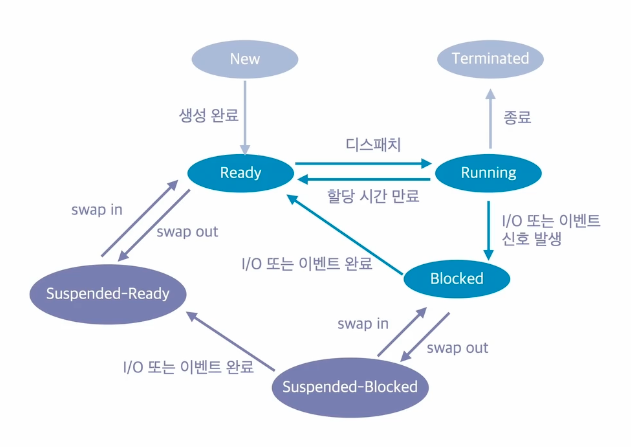
프로세스가 생성되었다고 해서 항상 CPU를 사용하고 있는 것은 아닙니다. CPU 할당을 기다리거나 입출력 작업이 끝날 때까지 대기하는 등 실행 과정에서 여러 상태를 거치게 됩니다.
프로세스의 주요 상태는 다음과 같습니다.
- New: 프로세스가 생성 중인 상태
- Ready: 프로그램이 메모리에 올라가 CPU 할당을 기다리는 상태
- Running: CPU를 점유하고 명령어를 수행 중인 상태
- Blocked: CPU를 할당받더라도 당장 명령어를 수행할 수 없는 상태
- 예: 프로세스가 입출력 작업의 완료를 기다리는 상황
- Terminated: 프로세스의 실행이 종료된 상태
- Suspended: 메모리 부족 등의 이유로 운영체제가 프로세스를 일시 중단하고 디스크로 내보낸 상태(Swap Out)
예를 들어 프로그램 A가 실행 중 디스크에서 데이터를 읽어야 하는 경우, 입출력 작업이 끝날 때까지 Blocked 상태로 전환됩니다. 이후 입출력이 완료되면 Ready 상태로 돌아와 CPU 할당을 기다리고, 다시 CPU를 할당받으면 Running 상태가 되어 실행을 이어갑니다.
여기서 디스패치(Dispatch)란 스케줄링을 통해 선택된 프로세스에 실제로 CPU를 할당하고 실행하는 과정을 의미합니다.
프로세스 상태 관리 — 큐와 스케줄러
컴퓨터에서는 여러 프로세스가 동시에 실행되기 때문에, 운영체제가 각 프로세스의 상태와 실행 순서를 관리해야 합니다.
이를 위해 운영체제는 큐(Queue)와 스케줄러(Scheduler)를 사용합니다.
큐(Queue)
큐는 프로세스가 실행되거나 특정 작업을 수행하기 위해 대기하는 공간입니다. 운영체제는 프로세스의 상태와 목적에 따라 여러 종류의 큐를 사용합니다.
1. Job Queue
- 아직 실행이 시작되지 않은 프로세스들이 포함된 큐
- 디스크에 저장된 상태로 메모리에 적재되기 전 단계
- 새로운 프로세스가 메모리에 적재되면 Job Queue에서 제거되고 Ready Queue로 이동
2. Ready Queue
- Ready 상태의 프로세스들이 대기하는 큐
- 운영체제는 스케줄러를 통해 Ready Queue에서 프로세스를 선택하고 CPU를 할당
3. Device Queue
- 입출력 장치의 작업을 기다리는 프로세스들의 큐
- 디스크, 프린터, 네트워크 등 각 장치마다 별도의 Device Queue 존재
- I/O 작업이 완료되면 프로세스는 Ready Queue로 복귀
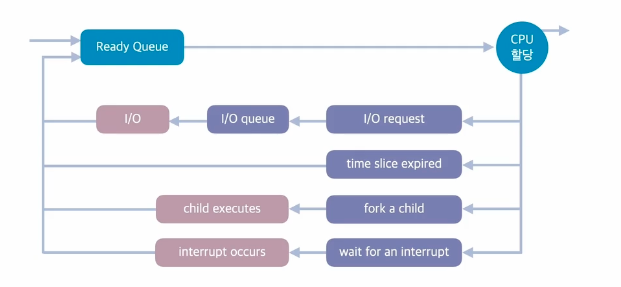
프로세스는 실행 도중 다양한 이유로 CPU를 반납하거나 다른 상태로 전환될 수 있습니다.
- I/O Request: 입출력이 필요한 경우 CPU를 반납하고 Device Queue(그림에서 빠짐)에서 작업 완료를 기다린 뒤 Ready Queue로 복귀
- Time Slice Expired: CPU에 할당된 사용 시간이 끝나면 CPU를 반납하고 Ready Queue에서 대기
- Fork a Child: 자식 프로세스를 생성한 뒤 CPU를 반납하는 경우 Ready Queue에서 대기
- Wait for an Interrupt: 특정 인터럽트를 기다리기 위해 CPU를 반납하고, 대기하던 이벤트가 발생하면 Ready Queue로 복귀
스케줄러(Scheduler)
앞서 운영체제가 여러 큐를 통해 프로세스를 관리한다는 것을 살펴봤습니다. 그렇다면 여러 프로세스 중 어떤 프로세스를 메모리에 올리고, 어떤 프로세스에 CPU를 할당할지는 누가 결정할까요?
이러한 역할을 담당하는 것이 스케줄러(Scheduler)입니다. 스케줄러는 역할에 따라 장기, 중기, 단기 스케줄러로 구분됩니다.
1. 장기 스케줄러(Long-Term Scheduler)
장기 스케줄러는 디스크에 있는 작업 중 어떤 작업을 메모리에 적재할지 결정합니다.
- 커널 메모리(RAM)에 있는 Job Queue에서 메모리에 적재할 작업을 선택
- 메모리 내 프로세스 수를 제한하여 메모리 과부하 방지
2. 중기 스케줄러(Medium-Term Scheduler)
중기 스케줄러는 메모리 자원이 부족할 때 프로세스를 일시적으로 디스크로 이동시키거나 다시 복구하는 역할을 합니다.
- 실행 중인 프로세스를 메모리에서 디스크로 이동하거나, 디스크에서 다시 메모리로 복구
- 메모리 부족 시, 우선순위가 낮은 프로세스를 Suspended 상태로 전환
- 예: 메모리가 부족할 때 I/O 작업을 기다리는 프로세스를 Suspended 상태로 전환하고, 메모리에 여유가 생기면 다시 복구
초기 운영체제에는 중기 스케줄러가 없었지만, 운영체제가 발전하면서 메모리 자원을 효율적으로 활용하는 것이 중요해졌고, 이에 따라 중기 스케줄러가 등장하게 되었습니다.
3. 단기 스케줄러(Short-Term Scheduler)
단기 스케줄러는 Ready Queue에서 실제로 CPU를 할당받을 프로세스를 선택합니다.
- Ready Queue에 있는 프로세스 중 CPU를 할당받아 실행할 프로세스 선택
- 매우 빠른 속도로 동작하며, 밀리초 단위의 짧은 간격으로도 실행
- CPU의 효율적인 사용을 위해 빈번하게 동작
- 다양한 스케줄링 알고리즘 사용
운영체제는 큐와 스케줄러를 어디에 저장할까?
운영체제도 프로그램이기 때문에 메모리에 코드, 데이터, 힙, 스택 등의 영역을 가지고 있습니다.
- Ready Queue, Device Queue: 운영체제의 커널 데이터 영역(RAM:메모리)에서 관리
- 스케줄러 및 스케줄링 알고리즘: 운영체제의 코드 영역에 구현
즉, 프로세스들을 관리하는 큐는 운영체제의 자료구조로 존재하고, 어떤 프로세스를 실행할지 결정하는 스케줄러는 운영체제의 코드로 구현되어 있습니다.
프로세스 제어 블록(PCB)
앞서 운영체제가 프로세스의 상태를 관리하고, 여러 프로세스에 CPU를 번갈아 할당한다는 것을 살펴봤습니다.
그렇다면 운영체제는 수많은 프로세스의 상태와 정보를 어디에 저장할까요?
이때 사용하는 자료구조가 프로세스 제어 블록(Process Control Block, PCB)입니다.
- 운영체제가 각 프로세스의 정보를 관리하기 위해 유지하는 커널 내부 자료구조
- 프로세스의 수행 상태와 관리 정보를 포함하며, 커널의 데이터 영역에 저장
PCB 주요 구성 요소
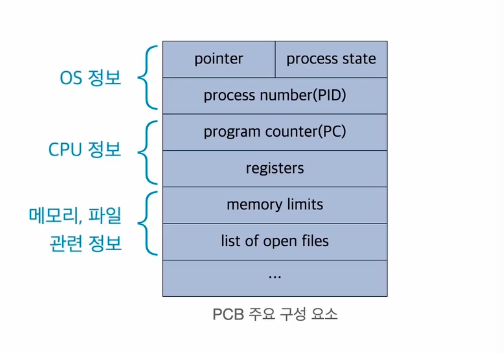
1. OS 정보
- 포인터(pointer): 큐에 연결된 PCB를 가리키는 용도
- 프로세스 상태(process state): Ready, Running, Blocked 등의 현재 상태
- 프로세스 ID(PID): 각 프로세스를 고유하게 식별하는 번호
- 스케줄링 정보: 프로세스 우선순위, CPU 할당 시간 등
2. CPU 정보
- 프로그램 카운터(PC): 다음에 수행할 명령어의 위치
- 레지스터(registers): CPU 연산 과정에서 사용했던 값의 정보
3. 메모리 정보
- 프로세스의 코드, 데이터, 스택 등의 주소 정보
4. 파일 관련 정보
- 프로세스가 어떤 파일을 읽고 있는지에 대한 정보
PCB는 프로세스의 실행 상태를 저장하고 관리하는 데 중요한 역할을 합니다.
예를 들어 CPU가 프로그램 A를 실행하다가 프로그램 B로 전환할 때, 운영체제는 프로그램 A의 실행 상태를 PCB에 저장하고 프로그램 B의 실행 상태를 복구합니다. 이러한 과정을 통해 CPU는 여러 프로세스를 번갈아 실행하더라도 각 프로세스의 작업을 이어갈 수 있습니다.
스레드(Thread)란?
지금까지 프로세스를 중심으로 운영체제의 실행 과정을 살펴봤습니다. 그런데 하나의 프로그램 안에서도 여러 작업을 동시에 처리해야 하는 경우가 있습니다.
예를 들어 웹 브라우저는 사용자 입력을 처리하면서 네트워크 데이터를 받아오고 화면을 업데이트해야 합니다. 이처럼 하나의 프로세스 안에서 여러 실행 흐름을 만들기 위해 사용하는 것이 스레드(Thread)입니다.
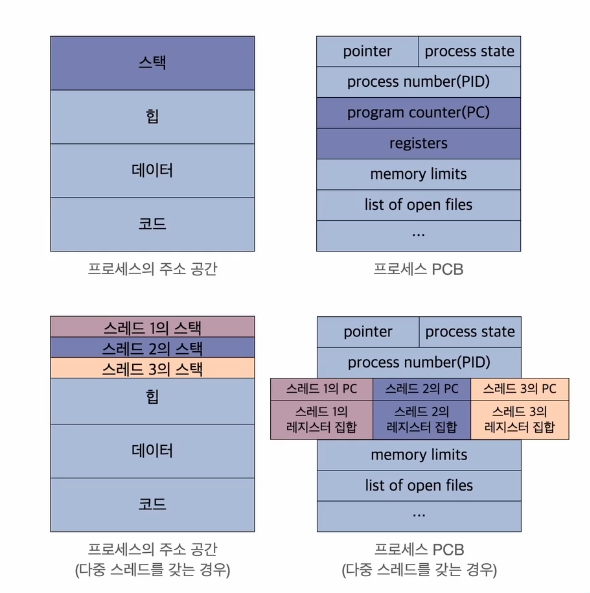
- 스레드는 프로세스의 실행 단위를 의미
- 스택, 스레드 ID, 프로그램 카운터(PC), 레지스터 집합 등으로 구성
- 같은 프로세스의 다른 스레드와 코드, 데이터, 힙 영역 및 운영체제 자원 등을 공유
- 스레드마다 독립적인 스택을 보유
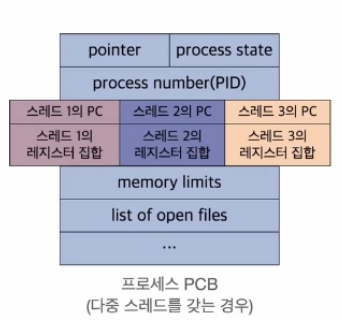
- 스레드마다 별도의 CPU 실행 상태(PC, 레지스터 집합)를 보유
스레드마다 스택을 가지는 이유
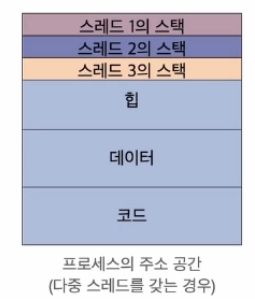
스택은 함수 호출 시 매개변수, 반환 주소, 지역 변수 등을 저장하는 메모리 공간입니다.
하나의 프로세스에서 여러 스레드가 서로 다른 함수를 실행할 수 있기 때문에, 각 스레드의 함수 호출 정보를 독립적으로 관리해야 합니다.
- 각 스레드가 독립적으로 함수를 호출하기 위해 별도의 스택 공간 필요
- 각 스레드의 실행 위치를 저장하기 위해 별도의 프로그램 카운터(PC) 필요
- 명령어 수행 중 사용하는 값을 관리하기 위해 별도의 레지스터 상태 필요
멀티스레딩(Multithreading)
멀티스레딩은 하나의 프로세스에서 여러 스레드를 생성하여 작업을 동시에 처리하는 기술입니다.
스레드들은 같은 프로세스의 메모리와 자원을 공유하기 때문에 프로세스 간에 데이터를 주고받는 것보다 효율적으로 작업을 처리할 수 있습니다.
장점
- 응답성 향상: 하나의 스레드가 Blocked 상태가 되더라도 다른 스레드는 계속 실행 가능
- 자원 공유: 스레드는 같은 프로세스의 메모리를 공유하므로 별도의 자원 복사가 필요하지 않아 프로세스 간 통신보다 빠른 데이터 교환 가능
- 비용 절감: 프로세스보다 스레드의 생성 및 관리 비용이 낮으며, 일반적으로 문맥 교환 비용도 적음
- 병렬 처리로 성능 향상: 멀티코어 CPU에서 여러 스레드를 병렬로 실행하여 성능 향상 가능
단점
- 공유 자원 접근 문제: 프로세스 간에는 기본적으로 메모리 자원이 분리되어 있지만, 같은 프로세스의 스레드들은 자원을 공유하므로 동일한 자원에 동시에 접근할 경우 문제 발생 가능
멀티프로세스(Multiprocessing)
멀티스레딩이 하나의 프로세스에서 여러 실행 흐름을 만드는 방식이라면, 멀티프로세스는 여러 개의 독립적인 프로세스를 사용하여 작업을 처리하는 방식입니다.
대표적인 예로 크롬 브라우저가 있습니다. 크롬은 탭과 웹 콘텐츠 등을 여러 프로세스로 분리하여 하나의 프로세스에서 문제가 발생하더라도 다른 프로세스에 미치는 영향을 줄입니다.
- 하나의 프로그램을 여러 개의 프로세스로 나누어 동시에 실행하는 구조
- 각 프로세스는 독립된 주소 공간과 자원을 보유
- 프로세스 간 메모리 공간이 분리되어 있어 서로 간섭하기 어려우므로 높은 안정성
- 대표적인 예: 크롬 브라우저의 탭 구조
장점
- 높은 안정성: 하나의 프로세스가 비정상 종료되더라도 다른 프로세스에 미치는 영향 최소화
- 병렬 처리 가능: 멀티코어 CPU에서 여러 프로세스를 동시에 실행
- 보안성 향상: 프로세스마다 주소 공간이 분리되어 있어 다른 프로세스의 메모리 침범 방지
단점
- 메모리 사용량 증가: 각 프로세스가 독립된 주소 공간을 가지므로 중복된 코드나 데이터가 존재할 수 있음
- 문맥 교환 비용 증가: 프로세스 전환 시 PCB에 실행 상태를 저장하고 복원하는 작업 필요
- 통신 복잡성 증가: 프로세스 간 데이터 교환을 위해 IPC(Inter-Process Communication) 필요
정리
이번에는 운영체제가 프로세스를 어떤 방식으로 관리하고 실행하는지 살펴봤습니다.
프로세스는 실행 중인 프로그램으로, 독립적인 주소 공간과 실행 상태를 가지고 있습니다. 운영체제는 PCB를 통해 프로세스의 정보를 관리하고, 큐와 스케줄러를 활용하여 CPU와 메모리 자원을 효율적으로 할당합니다.
또한 하나의 프로세스 안에서 여러 실행 흐름을 만드는 스레드와 여러 독립적인 프로세스를 활용하는 멀티프로세스 구조도 살펴봤습니다.
결국 운영체제는 여러 프로세스의 상태를 관리하고 CPU를 적절히 분배하여, 한정된 하드웨어 자원으로 여러 프로그램이 효율적으로 실행될 수 있도록 하는 역할을 수행합니다.