쿠버네티스 master plane 초기화(init)
본 포스트는 「실무까지 한 번에 끝내는 DevOps를 위한 Docker & Kubernetes feat. AWS EKS 초격차 패키지 Online」 강의를 학습하며 정리한 내용을 다룹니다.
Recap
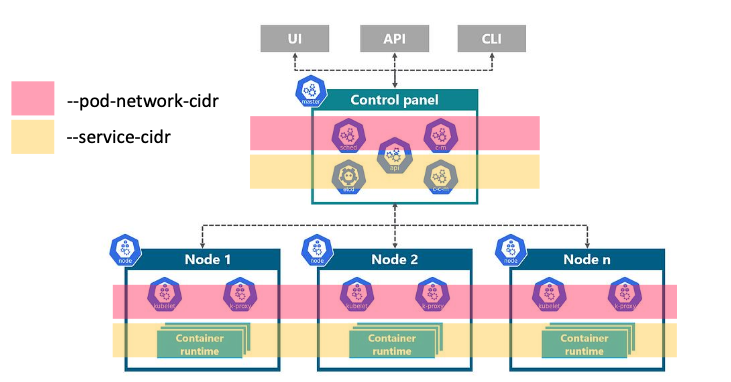
지난 과정을 통해 저희는 위 이미지와 같이 k8s-master 노드 1대와 k8s-node1,2,3 3대를 구축했습니다.
앞으로, k8s-master는 이름에 맞게 node1,2,3을 관리하는 마스터의 역할을 위해 'Control Plane' 라는 역할이 부여됩니다. 그리고 Control Plane이 node를 관리할 수 있게 등록(Join)하는 과정을 진행할 예정이며 이를 초기화(init) 작업 이라고 합니다.
(1) kubeadm init
강의에서 가장 먼저 실행한 핵심 명령어는 이것입니다.
sudo kubeadm init \
  --pod-network-cidr=10.96.0.0/12 \
  --apiserver-advertise-address=192.168.56.100
현재 서버를 Kubernetes 클러스터의 마스터 노드, 즉 control-plane으로 초기화하는 작업입니다.
Docker/EC2 관점으로 비유하면, EC2 서버 하나에 Docker만 설치했다고 해서 여러 서버의 컨테이너를 중앙에서 관리할 수 있는 것은 아닙니다. Kubernetes에서는 먼저 “이 서버가 클러스터의 중심 관리자다”라고 선언해야 합니다. 그 작업이 kubeadm init입니다.
이 명령어가 실행되면 내부적으로 다음 컴포넌트들이 준비됩니다.
- kube-apiserver Kubernetes : 클러스터의 API 서버. 모든 명령의 입구
- etcd : 클러스터 상태 저장소
- kube-scheduler : Pod를 어느 노드에 배치할지 결정
- kube-controller-manager : Deployment, ReplicaSet, Node 상태 등을 계속 감시하고 조정
- kubelet : 해당 노드에서 Pod 실행을 담당
- kube-proxy : Service 네트워크 라우팅 담당
실무에서는 kubeadm init이 성공했다는 것은 클러스터의 뼈대가 만들어졌다는 의미입니다. 아직 애플리케이션을 안정적으로 배포할 수 있는 완성 상태는 아닙니다. 뒤에서 CNI를 설치해야 노드와 Pod 네트워크가 정상화됩니다. 명령어의 파라미터에 대해서도 알아봅시다.
--pod-network-cidr
Pod들이 사용할 IP 주소 대역을 지정하는 옵션입니다. Kubernetes에서는 Pod마다 IP가 부여됩니다. 예를 들어 다음처럼 Pod IP가 생깁니다.
- Pod A: 10.x.x.x
- Pod B: 10.x.x.x
- Pod C: 10.x.x.x
이 IP들은 EC2나 VirtualBox VM의 IP가 아닙니다. 클러스터 내부에서 Pod 통신을 위해 사용하는 가상 네트워크 IP입니다. 실무에서는 여러 노드가 있을 때 각 노드에서 Pod가 생성됩니다.
k8s-node1
  └─ Pod A

k8s-node2
  └─ Pod B

k8s-node3
  └─ Pod C
이때 Pod IP 대역이 제대로 관리되지 않으면 문제가 생깁니다. 예를 들어 node1의 Pod와 node2의 Pod가 같은 IP를 받으면 통신 충돌이 발생합니다. 그래서 Kubernetes는 CNI 플러그인과 함께 Pod IP 대역을 나누어 각 노드에 할당합니다. (CNI 플러그인은 아래에서 자세하게 다룹니다.)
10.96.0.0/12에서 /12는 네트워크 Prefix 길이를 의미합니다. IP 주소 32비트 중에서 앞의 12비트는 네트워크 주소로 고정하고, 나머지 20비트는 그 안에서 사용할 수 있는 주소 범위로 쓰겠다는 뜻입니다.
- 전체 IPv4 비트 수: 32비트
- 네트워크 비트: 12비트
- 호스트 비트: 32 - 12 = 20비트
- 사용 가능한 주소 개수: 2^20 = 1,048,576개
즉 10.96.0.0/12는 IP 하나가 아니라, 약 104만 개의 IP를 포함하는 큰 네트워크 대역입니다.
--apiserver-advertise-address
이 옵션은 kube-apiserver가 클러스터 내부와 worker node들에게 알려줄 자신의 IP 주소입니다. 즉, worker node들이 master node에 join할 때 다음 주소로 접속합니다.
192.168.56.100:6443 → 여기서 6443은 kube-apiserver의 기본 HTTPS 포트입니다.
실무에서는 이 옵션을 worker node, 운영자 PC, 로드밸런서 등이 접근 가능한 안정적인 IP 또는 VIP로 지정합니다.
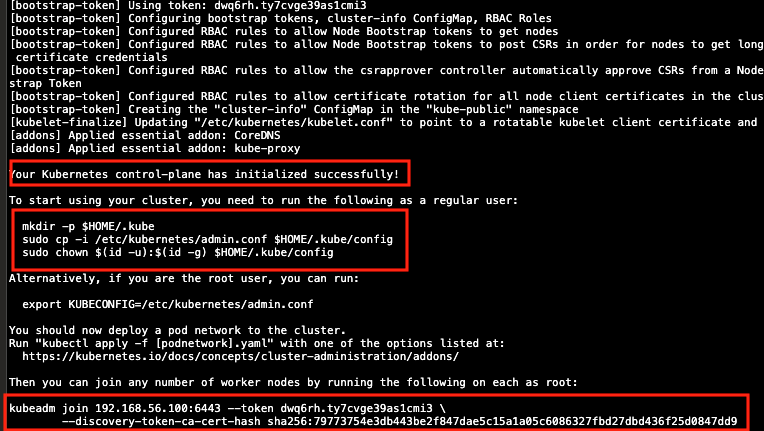
명령어가 성공하면 "Your Kubernetes control-plane has initialized successfully!"라는 문구와 함께 다음으로 수행해야하는 작업을 알려줍니다.
student@k8s-master:~$ mkdir -p $HOME/.kube
student@k8s-master:~$ sudo cp -i /etc/kubernetes/admin.conf $HOME/.kube/config
student@k8s-master:~$ sudo chown $(id -u):$(id -g) $HOME/.kube/config
kubectl은 Kubernetes API 서버에 요청을 보내는 CLI 도구입니다. 그런데 API 서버는 아무나 접근하게 두면 안 됩니다. 그래서 인증 정보가 필요합니다. 그 인증 정보가 들어있는 파일이 바로: /etc/kubernetes/admin.conf 입니다.
명령어 순서대로, 현재 사용자의 홈 디렉터리에 .kube 디렉터리를 만들고 관리자용 kubeconfig 파일을 현재 사용자 설정으로 복사합니다. 그리고 복사한 파일의 소유자를 현재 사용자로 변경합니다. 이걸 하지 않으면 kubectl 실행 시 권한 문제가 생길 수 있습니다.
운영 환경에서는 아무 사용자에게나 admin.conf를 복사하지 않습니다. 이 파일은 클러스터 관리자 권한을 갖기 때문에 매우 강력합니다.
sudo kubeadm join 192.168.56.100:6443 --token dwq6rh.ty7cvge39as1cmi3 \
--discovery-token-ca-cert-hash sha256:79773754e3db443be2f847dae5c15a1a05c6086327fbd27dbd436f25d0847dd9
kubeadm init이 성공하면 아래와 같은 명령어가 마지막에 출력됩니다. 이 명령어는 worker node를 control-plane에 등록시키는 명령어입니다. 즉, master node에서 실행하는 게 아니라, k8s-node1, k8s-node2, k8s-node3 같은 worker node에서 실행합니다.
- 192.168.56.100:6443 : master node의 kube-apiserver 주소
- -token : join 권한을 확인하기 위한 임시 토큰
- -discovery-token-ca-cert-hash : 접속하려는 API 서버가 진짜 master인지 검증하는 CA 인증서 해시
kubeadm token create --print-join-command실무에서는 이 join 명령어를 반드시 기록해두는 게 좋습니다. 다만 토큰은 기본적으로 만료 시간이 있습니다. 만료되면 master node에서 위 명령어로 새로 발급해야 합니다.
(2) Kubernetes를 위한 열린 포트 확인
student@k8s-master:~$ sudo netstat -ntlp | grep LISTEN
tcp        0      0 127.0.0.1:42393         0.0.0.0:*               LISTEN      1503/containerd
tcp        0      0 192.168.56.100:2379     0.0.0.0:*               LISTEN      15043/etcd
tcp        0      0 192.168.56.100:2380     0.0.0.0:*               LISTEN      15043/etcd
tcp        0      0 127.0.0.53:53           0.0.0.0:*               LISTEN      632/systemd-resolve
tcp        0      0 127.0.0.54:53           0.0.0.0:*               LISTEN      632/systemd-resolve
tcp        0      0 127.0.0.1:2379          0.0.0.0:*               LISTEN      15043/etcd
tcp        0      0 127.0.0.1:2381          0.0.0.0:*               LISTEN      15043/etcd
tcp        0      0 127.0.0.1:10259         0.0.0.0:*               LISTEN      15045/kube-schedule
tcp        0      0 127.0.0.1:10257         0.0.0.0:*               LISTEN      15056/kube-controll
tcp        0      0 127.0.0.1:10249         0.0.0.0:*               LISTEN      15345/kube-proxy
tcp        0      0 127.0.0.1:10248         0.0.0.0:*               LISTEN      15257/kubelet
tcp        0      0 127.0.0.1:631           0.0.0.0:*               LISTEN      14166/cupsd
tcp        0      0 0.0.0.0:22              0.0.0.0:*               LISTEN      1/systemd
tcp6       0      0 ::1:631                 :::*                    LISTEN      14166/cupsd
tcp6       0      0 :::6443                 :::*                    LISTEN      15046/kube-apiserve
tcp6       0      0 :::10256                :::*                    LISTEN      15345/kube-proxy
tcp6       0      0 :::22                   :::*                    LISTEN      1/systemd
tcp6       0      0 :::10250                :::*                    LISTEN      15257/kubelet
현재 서버에서 열려 있는 TCP 포트와 해당 프로세스를 확인하는 명령어입니다. 출력 중 중요한 부분은 ':::6443 LISTEN kube-apiserver' 입니다.
Kubernetes에서 worker node, kubectl, controller 등은 대부분 kube-apiserver를 통해 통신합니다. 즉, 6443 포트가 열려 있어야 합니다.
그 외에 kube-proxy, kubeleet 등 Kubernetes에 필요한 포트가 열린것을 확인합니다.
| 6443 | kube-apiserver | Kubernetes API 서버 |
|---|---|---|
| 2379, 2380 | etcd | 클러스터 상태 저장소 |
| 10250 | kubelet | 노드의 kubelet API |
| 10257 | kube-controller-manager | 컨트롤러 매니저 |
| 10259 | kube-scheduler | 스케줄러 |
| 10256 | kube-proxy | kube-proxy health check |
실무에서는 방화벽, 보안 그룹, NACL, iptables 설정 때문에 이 포트들이 막히는 경우가 많습니다.
(3) worker node를 master plane에 등록(join) 실행
student@k8s-master:~$ kubectl get node
NAME         STATUS     ROLES           AGE     VERSION
k8s-master   NotReady   control-plane   7m42s   v1.28.15
'kubectl get node'를 통해 현재 클러스터 상태를 확인합니다. master node가 클러스터에 등록되긴 했지만, 'NotReady' 상태(STATUS)로 아직 정상적으로 Pod 네트워크가 준비되지 않았습니다.
student@k8s-master:~$ kubectl get po -A
NAMESPACE     NAME                                 READY   STATUS    RESTARTS   AGE
kube-system   coredns-5dd5756b68-dxzwh             0/1     Pending   0          7m42s
kube-system   coredns-5dd5756b68-jjqmj             0/1     Pending   0          7m42s
kube-system   etcd-k8s-master                      1/1     Running   0          7m56s
kube-system   kube-apiserver-k8s-master            1/1     Running   0          7m56s
kube-system   kube-controller-manager-k8s-master   1/1     Running   0          7m55s
kube-system   kube-proxy-4qr45                     1/1     Running   0          7m42s
kube-system   kube-scheduler-k8s-master            1/1     Running   0          7m55s
현재 클러스터의 모든 namespace의 Pod를 조회합니다. -A는 --all-namespaces의 줄임말입니다.
| Pod 명 | 상태 | 의미 |
|---|---|---|
| etcd | Running | 클러스터 상태 저장소 정상 |
| kube-apiserver | Running | API 서버 정상 |
| kube-controller-manager | Running | 컨트롤러 정상 |
| kube-scheduler | Running | 스케줄러 정상 |
| kube-proxy | Running | Service 네트워크 일부 준비 |
| coredns | Pending | 아직 네트워크 준비 전일 가능성 높음 |
kube-apiserver, kube-proxy 등 Master Plance에 필요한 Pod(또는 컨테이너)는 정상적으로 실행중입니다. 이는 새로운 Worker Node를 등록(JOIN)시킬 준비가 된 상태라고 봐도될꺼같습니다.
student@k8s-node1:~$ sudo kubeadm join 192.168.56.100:6443 --token dwq6rh.ty7cvge39as1cmi3 \
--discovery-token-ca-cert-hash sha256:79773754e3db443be2f847dae5c15a1a05c6086327fbd27dbd436f25d0847dd9
[sudo: authenticate] Password:
[preflight] Running pre-flight checks
[preflight] Reading configuration from the cluster...
[preflight] FYI: You can look at this config file with 'kubectl -n kube-system get cm kubeadm-config -o yaml'
[kubelet-start] Writing kubelet configuration to file "/var/lib/kubelet/config.yaml"
[kubelet-start] Writing kubelet environment file with flags to file "/var/lib/kubelet/kubeadm-flags.env"
[kubelet-start] Starting the kubelet
[kubelet-start] Waiting for the kubelet to perform the TLS Bootstrap...

This node has joined the cluster:
* Certificate signing request was sent to apiserver and a response was received.
* The Kubelet was informed of the new secure connection details.

Run 'kubectl get nodes' on the control-plane to see this node join the cluster.
(1) kubeadm init 단계에서 기록하라고 했던 worker node를 control-plane에 등록시키는 명령어입니다. 이 명령어를 (중요)student@k8s-node1에 실행해서 master plande에 등록(JOIN)을 시키겠습니다.
내부적으로는 이런 일이 일어납니다.
- worker node의 kubelet이 API 서버에 접속합니다.
- 토큰과 CA 해시로 클러스터를 검증합니다.
- kubelet이 인증서 요청을 보냅니다.
- control-plane이 이를 승인합니다.
- worker node가 클러스터의 Node 리소스로 등록됩니다.
student@k8s-master:~$ kubectl get nodes
NAME         STATUS     ROLES           AGE   VERSION
k8s-master   NotReady   control-plane   11m   v1.28.15
k8s-node1    NotReady   <none>          39s   v1.28.15
그 후 master node에서 확인합니다. k8s-node1이 등록된 모습을 확인할 수 있습니다. 하지만 여전히 NotReady 상태군요. 여기서 worker node도 NotReady인 이유는 마찬가지로 CNI가 아직 설치되지 않았기 때문입니다.
CNI(Container Network Interface) 란?
- CNI는 컨테이너 간의 네트워킹을 제어할 수 있는 Plugin을 만들기 위한 표준
- CNI는 Pod 생성~삭제 시 마다 호출되는 API의 규격과 인터페이스를 정의
- 다양한 형태의 컨테이너 런타임과 오케스트레이터 사이의 네트워크 계층을 구현하는 방식이 다양하게 분리되어 각자만의 방식으로 발전하게 되는 것을 방지하고 공통된 인터페이스를 제공. k8s는 Pod간의 통신을 위해서 CNI를 사용.
- 공통된 CNI로 네트워크를 Pod에 구축하지 않으면 동기화가 안됨.
- k8s는 기본적으로 'kubenet'이라는 자체적인 CNI Plugin을 제공하지만 네트워크 기능이 매우 제한적임. 그 단점 보완을 위해 3rd-party Plugin을 제공. Flannel, Calico, Weavenet 등 다양한 종류의 CNI Plugin들을 제공
CNI 필요성
- 여러 개의 node로 구성된 Kubernetes cluster 환경에서, 각 노드에 존재하는 container network의 IP 대역이 동일하여 Pod들이 같은 IP를 할당 받을 가능성이 높음
- Pod의 IP가 다르게 할당되었다 하더라도 해당 Pod가 어느 노드에 존재하는지 확인 불가(자신의 노드에 있는 Pod IP만 식별 가능하므로)
- 따라서, 중복되지 않는 IP를 부여해줄 역할을 CNI Plugin 수행. CNI Plugin은 모든 worker node에게 중복되지 않는 subnet을 부여. Worker node에서 실행되는 Pod는 해당 subnet에 포함된 IP를 제공 받음.
CNI 구성
- CNI가 브릿지 인터페이스를 만들고, 컨테이너 네트워크 대역대를 나누어 라우팅 테이블을 생성
- Pod들은 CNI에 의해 제공되는 고유의 IP를 갖는다.
- 클러스터 내의 모든 Pod들은 내부 네트워크가 자동으로 구성되어 Service 없이도 Pod간 통신이 가능하다.
- CNI Provider는 VXLAN(Virtual Extensible Lan), IP-in-IP 과 같은 캡슐화된 네트워크 모델 또는, BGP(Border Gateway Protocol)와 같은 캡슐화 되지 않은 네트워크 모델을 사용하여 네트워크 패브릭 구현
CNI 3rd-party plugin
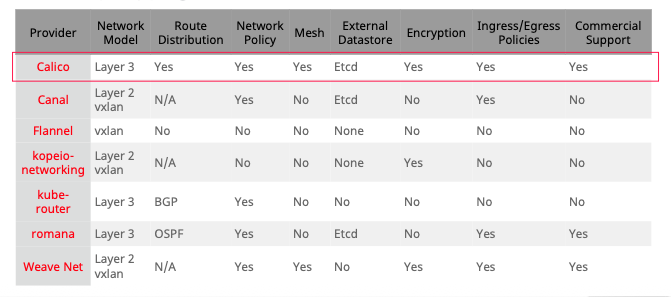
이 중에서 저희는 Calico 플러그인을 사용하겠습니다.
(4) Calico 설치
student@k8s-master:~$ curl -O https://raw.githubusercontent.com/projectcalico/calico/v3.25.0/manifests/calico.yaml
  % Total    % Received % Xferd  Average Speed  Time    Time    Time   Current
                                 Dload  Upload  Total   Spent   Left   Speed
100 232.5k 100 232.5k   0      0 234.6k      0

student@k8s-master:~$ ls
Desktop  Documents  Downloads  Music  Pictures  Public  Templates  Videos  calico.yaml  snap
Calico 설치용 YAML 파일을 다운로드합니다. 설치가 끝나면 바탕화면에 'calico.yaml'가 설치됬는지 확인해봅니다.
student@k8s-master:~$ kubectl apply -f calico.yaml

poddisruptionbudget.policy/calico-kube-controllers created
serviceaccount/calico-kube-controllers created
serviceaccount/calico-node created
configmap/calico-config created
customresourcedefinition.apiextensions.k8s.io/bgpconfigurations.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/bgppeers.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/blockaffinities.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/caliconodestatuses.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/clusterinformations.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/felixconfigurations.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/globalnetworkpolicies.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/globalnetworksets.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/hostendpoints.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/ipamblocks.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/ipamconfigs.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/ipamhandles.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/ippools.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/ipreservations.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/kubecontrollersconfigurations.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/networkpolicies.crd.projectcalico.org created
customresourcedefinition.apiextensions.k8s.io/networksets.crd.projectcalico.org created
clusterrole.rbac.authorization.k8s.io/calico-kube-controllers created
clusterrole.rbac.authorization.k8s.io/calico-node created
clusterrolebinding.rbac.authorization.k8s.io/calico-kube-controllers created
clusterrolebinding.rbac.authorization.k8s.io/calico-node created
daemonset.apps/calico-node created
deployment.apps/calico-kube-controllers created
다운로드한 Kubernetes 리소스들을 클러스터에 적용합니다.
Calico 관련 컨트롤러 실행, Calico 전용 Kubernetes 리소스 타입 추가, 모든 노드에 Calico 네트워크 에이전트 실행 등 작업을 일괄적으로 수행하며 쿠버네티스에서 Calico를 사용할 수 있도록 세팅합니다.
student@k8s-master:~$ kubectl get po -A
NAMESPACE     NAME                                       READY   STATUS     RESTARTS   AGE
kube-system   calico-kube-controllers-658d97c59c-fdzbx   0/1     Pending    0          26s
kube-system   calico-node-4b4wn                          0/1     Init:2/3   0          26s
kube-system   calico-node-g887c                          0/1     Init:2/3   0          26s
kube-system   coredns-5dd5756b68-dxzwh                   0/1     Pending    0          20m
kube-system   coredns-5dd5756b68-jjqmj                   0/1     Pending    0          20m
kube-system   etcd-k8s-master                            1/1     Running    0          20m
kube-system   kube-apiserver-k8s-master                  1/1     Running    0          20m
kube-system   kube-controller-manager-k8s-master         1/1     Running    0          20m
kube-system   kube-proxy-4qr45                           1/1     Running    0          20m
kube-system   kube-proxy-rg8ds                           1/1     Running    0          10m
kube-system   kube-scheduler-k8s-master                  1/1     Running    0          20m
세팅이 시작되면, kube system에 calico 노드 준비중인것을 확인할 수 있습니다. Calico는 네트워크 설정을 위해 노드에 필요한 파일, 인터페이스, 라우팅 설정 등을 준비합니다. 그래서 설치 직후에는 잠깐 시간이 걸릴 수 있습니다.
student@k8s-master:~$ kubectl get po -A
NAMESPACE     NAME                                       READY   STATUS    RESTARTS   AGE
kube-system   calico-kube-controllers-658d97c59c-fdzbx   1/1     Running   0          62s
kube-system   calico-node-4b4wn                          1/1     Running   0          62s
kube-system   calico-node-g887c                          1/1     Running   0          62s
kube-system   coredns-5dd5756b68-dxzwh                   1/1     Running   0          21m
kube-system   coredns-5dd5756b68-jjqmj                   1/1     Running   0          21m
kube-system   etcd-k8s-master                            1/1     Running   0          21m
kube-system   kube-apiserver-k8s-master                  1/1     Running   0          21m
kube-system   kube-controller-manager-k8s-master         1/1     Running   0          21m
kube-system   kube-proxy-4qr45                           1/1     Running   0          21m
kube-system   kube-proxy-rg8ds                           1/1     Running   0          11m
kube-system   kube-scheduler-k8s-master                  1/1     Running   0          21m
설치가 끝나면 Running 상태로 변하게 됩니다. 즉, CNI가 설치되면서 클러스터 네트워크가 준비되고, 시스템 Pod들도 정상화됩니다.
student@k8s-master:~$ kubectl get node
NAME         STATUS   ROLES           AGE   VERSION
k8s-master   Ready    control-plane   21m   v1.28.15 # NotReady -> Ready로 바뀜
k8s-node1    Ready    <none>          11m   v1.28.15 # NotReady -> Ready로 바뀜
클러스터에 등록된 노드들 또한 CNI가 설치되면서 상태가 NotReady → Ready로 바뀌면서, 이제 각 노드가 Kubernetes에서 Pod를 실행할 준비가 되었다는 뜻입니다. NotReady에서 Ready로 바뀌는 핵심 조건 중 하나가 네트워크 플러그인 준비 여부입니다.
student@k8s-master:~$ route -n
Kernel IP routing table
Destination     Gateway         Genmask         Flags Metric Ref    Use Iface
0.0.0.0         10.0.2.2        0.0.0.0         UG    101    0        0 enp0s8
0.0.0.0         192.168.56.2    0.0.0.0         UG    20100  0        0 enp0s9
10.0.2.0        0.0.0.0         255.255.255.0   U     101    0        0 enp0s8
10.108.82.192   0.0.0.0         255.255.255.192 U     0      0        0 *
10.108.82.193   0.0.0.0         255.255.255.255 UH    0      0        0 cali2b95aebc898
10.108.82.194   0.0.0.0         255.255.255.255 UH    0      0        0 cali9306328d361
10.108.82.195   0.0.0.0         255.255.255.255 UH    0      0        0 caliba45c680160
10.111.156.64   192.168.56.101  255.255.255.192 UG    0      0        0 tunl0
172.17.0.0      0.0.0.0         255.255.0.0     U     0      0        0 docker0
192.168.56.0    0.0.0.0         255.255.255.0   U     100    0        0 enp0s9
route -n은 리눅스 서버의 라우팅 테이블을 숫자 형태로 보여주는 명령어입니다. 쉽게 말하면 라우팅 테이블은 서버가 네트워크 패킷을 보낼 때 참고하는 길 안내표입니다. 서버가 어떤 IP로 패킷을 보낼 때 이런 판단을 해야 합니다.
- 목적지 IP가 192.168.56.101이면 어디로 보내야 하지?
- 목적지 IP가 8.8.8.8이면 어디로 보내야 하지?
- 목적지 IP가 같은 네트워크 안에 있나?
- 아니면 게이트웨이를 통해 밖으로 보내야 하나?
이때 참고하는 표가 라우팅 테이블입니다. Docker나 Kubernetes 환경에서는 이 개념이 더 중요합니다. Pod, Service, Node, 외부 인터넷이 각각 다른 네트워크 대역을 쓰기 때문에, 리눅스 커널이 “어느 인터페이스로 패킷을 보낼지”를 정확히 알아야 합니다.
10.108.82.192   0.0.0.0         255.255.255.192 U     0      0        0 *
10.108.82.193   0.0.0.0         255.255.255.255 UH    0      0        0 cali2b95aebc898
10.111.156.64   192.168.56.101  255.255.255.192 UG    0      0        0 tunl0
출력된 라우팅 테이블 일부를 보면, Calico가 설치되면서 Pod 네트워크에 필요한 라우팅 정보가 생긴 것입니다.
- cali... : Calico가 Pod 연결을 위해 만든 가상 인터페이스
- tunl0 : IP-in-IP 터널링에 사용될 수 있는 인터페이스
- 192.168.56.101 : 다른 worker node로 가는 경로
- 10.x.x.x : Pod 네트워크 대역
student@k8s-master:~$ kubectl cluster-info
Kubernetes control plane is running at https://192.168.56.100:6443
CoreDNS is running at https://192.168.56.100:6443/api/v1/namespaces/kube-system/services/kube-dns:dns/proxy

To further debug and diagnose cluster problems, use 'kubectl cluster-info dump'.
'kubectl cluster-info'는 클러스터의 주요 엔드포인트 정보를 보여줍니다.
- Kubernetes control plane : API 서버가 정상 동작 중
- CoreDNS : 클러스터 DNS가 정상 동작 중
CoreDNS가 정상이라는 것은 Pod들이 서비스 이름으로 통신할 수 있다는 의미입니다. 예를 들어 나중에 이런 통신이 가능해집니다.
student@k8s-master:~$ kubeadm config print init-defaults
apiVersion: kubeadm.k8s.io/v1beta3
bootstrapTokens:
- groups:
  - system:bootstrappers:kubeadm:default-node-token
  token: abcdef.0123456789abcdef
  ttl: 24h0m0s
  usages:
  - signing
  - authentication
kind: InitConfiguration
localAPIEndpoint:
  advertiseAddress: 1.2.3.4
  bindPort: 6443
nodeRegistration:
  criSocket: unix:///var/run/containerd/containerd.sock
  imagePullPolicy: IfNotPresent
  name: node
  taints: null
---
apiServer:
  timeoutForControlPlane: 4m0s
apiVersion: kubeadm.k8s.io/v1beta3
certificatesDir: /etc/kubernetes/pki
clusterName: kubernetes
controllerManager: {}
dns: {}
etcd:
  local:
    dataDir: /var/lib/etcd
imageRepository: registry.k8s.io
kind: ClusterConfiguration
kubernetesVersion: 1.28.0
networking:
  dnsDomain: cluster.local
  serviceSubnet: 10.96.0.0/12
scheduler: {}
kubeadm init에서 사용할 수 있는 기본 설정값을 YAML 형식으로 출력합니다. 저희는 init을 kubeadm init --pod-network-cidr=... 이렇게 파라미터를 직접 입력했지만, 실무에서는 설정이 많아지기 때문에 보통 kubeadm config 파일을 만들어 관리합니다.
kubeadm init --config kubeadm-config.yaml이렇게 하면 클러스터 초기화 설정을 Git으로 관리할 수 있습니다. 이때 적용된 설정값을 조회할 때, 'kubeadm config print init-defaults' 명령어로 확인할 수 있습니다.
마무리
이번 포스트는 k8s-master를 master plane로 설정하고, k8s-node1 를 worker node로 등록(JOIN)하는 과정을 실습해봤습니다.
핵심은, kubeadm init만 했다고 클러스터가 완성된 것이 아닙니다. CNI까지 설치되어야 노드가 Ready 상태가 됩니다.
다음 시간에는 남은 노드를 등록하여 클러스터를 확장하는 실습을 진행해보겠습니다.