eRPC를 활용한 Multi RPC-Provider Failover 및 이중화 아키텍처
Layer2 안정성을 위한 Layer1 RPC Failover
Intro: Layer2 안정성을 좌우하는 Layer1 RPC 통신
이번에 op-stack 기반의 Layer2 인프라를 구축하고 설계하는 과정에서 Layer1, 즉 이더리움과의 통신이 Layer2 체인의 안정적인 운영에 매우 중요한 역할을 한다는 점을 경험했는데요. 특히 Sequencer를 운영하는 입장에서 Layer1 이더리움과의 RPC 통신은 더욱 중요했었습니다.
이더리움과의 RPC 통신 과정에서 지연이나 Timeout이 발생하면 Layer2의 블록 생성 역시 해당 시간 동안 지연될 수 있으며, 실제 운영 과정에서는 최대 180초까지 블록 생성이 지연되는 상황도 경험했습니다. 이번에 구축한 블록체인은 빠른 결제와 정산을 위해 Layer2 구조를 선택했고, 특히 핀테크 서비스에서 결제와 정산을 목적으로 운영되는 네트워크입니다. 이러한 환경에서는 몇 초의 지연만으로도 서비스 운영에 치명적인 영향을 줄 수 있습니다.
이 글에서는 Layer2 블록체인 인프라를 설계하고 운영하는 과정에서 경험한 Layer1 RPC 통신 문제를 살펴보고, 이를 해결하기 위해 어떤 구조와 방식을 적용했는지 정리해보고자 합니다.
직면한 문제
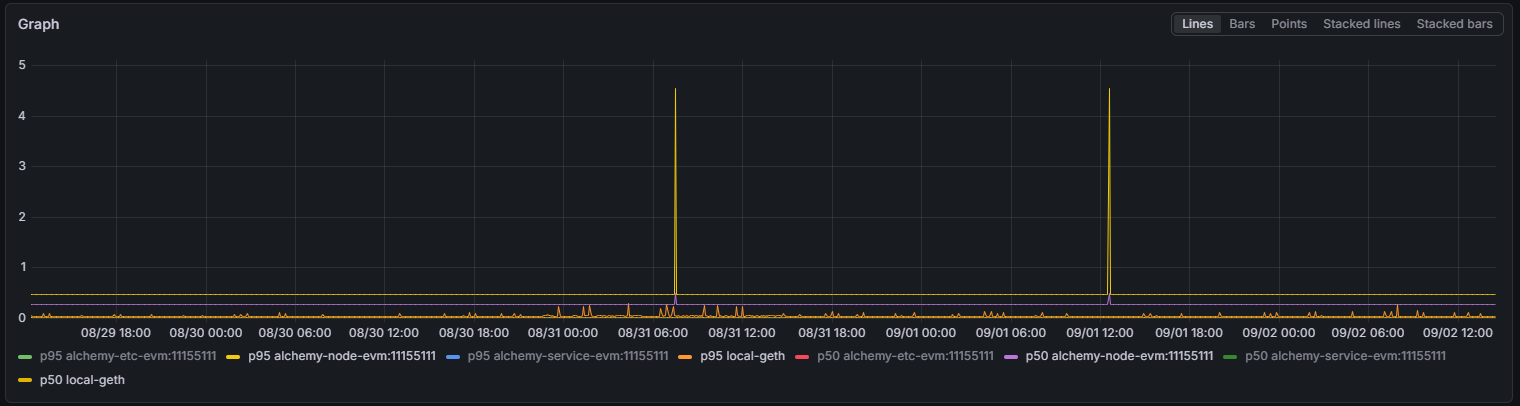
기존에는 L1 RPC Provider로 Alchemy를 사용하고 있었습니다. Alchemy는 요청량을 CU(Compute Unit)라는 단위로 계산해 과금하는 구조인데, 운영 과정에서 예상보다 잦은 응답 지연과 Timeout이 발생했었습니다 실제 모니터링 결과 Alchemy RPC의 응답 시간은 다음과 같았습니다.
           │    p50    │    p95
alchemy    │ 227~275ms │ 474~478ms
평상시에도 p50 기준 약 275ms, p95 기준 약 479ms의 응답 시간이 발생했고, 간헐적으로는 응답 시간이 4.5초까지 치솟는 구간도 확인할 수 있었습니다. 문제는 단순히 RPC 응답이 몇백 ms 느린 수준에서 끝나지 않았다는 점입니다. 하루에 1,000개 이상의 블록에서 Timeout으로 인한 생성 지연이 발생했으며, context deadline exceeded 로그 역시 하루에 약 40~250건씩 지속적으로 발생했었습니다.
context deadline exceeded는 지정된 시간 안에 RPC 요청이 완료되지 못해 Timeout이 발생했다는 의미입니다. 이러한 Timeout이 연속적으로 발생하면 요청이 다시 시도되고, 재시도 과정에서 또다시 Timeout이 발생하는 연쇄적인 지연으로 이어질 수 있고, 실제 운영 과정에서는 이러한 문제가 겹치면서 최대 180초까지 블록 생성이 지연되는 상황도 경험했었습니다.
이번 블록체인 네트워크의 목표 블록 생성 주기는 1초입니다. 따라서 수백 ms 수준의 RPC 지연도 블록 생성 주기와 비교하면 무시하기 어렵고, 수 초 이상의 지연이나 Timeout은 블록 생성 속도에 직접적인 영향을 줄 수밖에 없습니다. 특히 OP Stack의 블록 생성 구조를 살펴보면, 왜 L1 RPC의 응답 지연이 그대로 L2 블록 생성 지연으로 이어지는지 알 수 있습니다.
L1 RPC와 블록 생성 프로세스
Sequencer는 새로운 L2 블록을 만들기 위해 L1의 최신 상태를 확인해야 합니다. 이 과정에서 새로운 L1 Block을 확인하면 다음과 같은 RPC 요청을 통해 해당 블록의 정보를 조회합니다.
> eth_getBlockByHash("new block hash", true)두 번째 파라미터를 true로 전달하면 단순히 블록에 포함된 Transaction Hash만 반환하는 것이 아니라, 각 Transaction의 상세 객체까지 함께 조회합니다.
OP Stack에서 이러한 L1 정보가 필요한 이유는 Layer2가 Layer1의 상태를 기반으로 블록을 생성하기 때문입니다. 대표적으로 L1에서 발생한 Deposit Transaction을 확인해 L2에서 실행해야 하며, L1 Block Number, Block Hash, Base Fee와 같이 L2 블록을 구성하는 데 필요한 정보 역시 함께 참조합니다.
이러한 L1 정보는 단순한 참고 데이터가 아니라 실제 L2 블록의 구성에 포함됩니다.
OP Stack 기반 Layer2 체인의 블록에는 첫 번째 Transaction으로 L1 Attributes Deposited Transaction이 포함됩니다. 이 Transaction의 calldata에는 L1 Block Number와 Hash, Base Fee를 비롯해 L2 블록 생성에 필요한 여러 L1 정보가 담깁니다.
즉, Sequencer는 L1 정보를 정상적으로 가져와야 다음 L2 블록을 구성할 수 있습니다.
// StartBuildingBlock initiates a block building job on top of the given L2 head,
// safe and finalized blocks, and using the provided l1 Origin.
func (s *Sequencer) startBuildingBlock() {
	ctx := s.ctx
	l2Head := s.unsafeHead

...여기서 중요한 부분은 Sequencer의 블록 생성 과정입니다. OP Stack의 Sequencer는 하나의 블록을 생성하는 과정에서는 L1 Origin을 결정하고 필요한 정보를 조회한 뒤 Payload를 생성하고 블록을 완성하는 작업이 하나의 goroutine에서 순차적(직렬)으로 이어집니다.
따라서 블록 생성 초기에 필요한 L1 RPC 요청이 지연되거나 실패하면, 그 뒤에 이어지는 블록 생성 단계 역시 진행할 수 없습니다. OP Stack 역시 이러한 RPC 통신 장애를 고려해 Timeout과 Retry 메커니즘을 두고 있습니다.
...

s.log.Info("Started sequencing new block", "parent", l2Head, "l1Origin", l1Origin)

fetchCtx, cancel := context.WithTimeout(ctx, time.Second*20)
defer cancel()

...블록 생성에 필요한 정보를 조회하는 과정에서 최대 20초의 Timeout을 설정하고 있으며, 요청에 실패하면 일정 시간 이후 다시 블록 생성을 시도합니다.
문제는 L1 RPC 장애가 일시적인 것이 아니라 연속적으로 발생하는 경우입니다. 예를 들어 하나의 요청이 20초 동안 응답을 받지 못해 Timeout되고, 이후 Retry에서도 같은 문제가 반복된다면 지연 시간이 계속 누적됩니다. 결국 RPC Provider의 일시적인 응답 지연이 단순히 하나의 API 호출이 느려지는 문제로 끝나는 것이 아니라, Sequencer의 블록 생성 자체를 지연시키는 문제로 확대될 수 있습니다.
이 문제를 해결하기 위해서는 단순히 더 빠른 RPC Provider를 찾는 것보다, 특정 RPC Provider에 장애나 지연이 발생하더라도 Sequencer가 영향을 최소화하면서 계속 L1과 통신할 수 있는 구조가 필요했습니다.
자체 dedicate 노드 구축
Provider 통신 문제를 해결하는 가장 확실한 방법은 블록을 생성하는 Sequencer와 동일한 AZ와 VPC 내부에 L1 노드를 직접 구축하는 것입니다. 외부 RPC Provider에 의존하지 않고, 네트워크와 최대한 가까운 위치에서 L1 데이터를 조회하도록 만드는 방식입니다.
이를 위해 Execution Layer에는 Geth, Consensus Layer에는 Lighthouse를 사용해 Ethereum Dedicated Node를 구축하기로 했습니다. 동일한 VPC와 AZ 안에서 통신하면 물리적인 거리로 인해 발생하는 네트워크 지연을 최소화할 수 있고, 여러 사용자가 함께 사용하는 Alchemy RPC와 달리 저희 체인만 사용하는 전용 노드이기 때문에 트래픽 증가로 인한 성능 저하 가능성도 줄일 수 있을 것이라 판단했습니다.
또다시 직면한 문제
하지만 Dedicated Node를 한 대만 구축하면 또 다른 문제가 생깁니다. 해당 노드가 장애를 일으킬 경우 그 자체가 단일 장애 지점(Single Point of Failure)이 되고, 최악의 경우 Sequencer가 L1 정보를 조회하지 못해 블록 생성을 중단할 수도 있습니다. 따라서 안정적인 구성을 위해서는 최소 2대 이상의 L1 노드, 즉 이중화 작업이 필요했습니다.
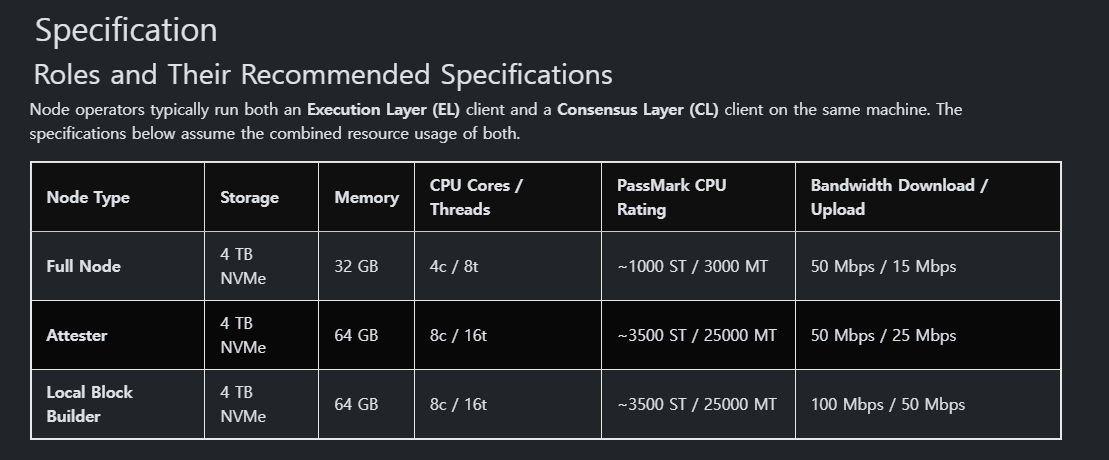
문제는 Ethereum Node가 상당히 높은 하드웨어 스펙을 요구한다는 점이었습니다. EIP-7870에서 권장하는 하드웨어 스펙만 보더라도 결코 작은 규모의 서버가 아닙니다. 이미 Layer2 네트워크 인프라를 구축하면서 다수의 노드를 운영하고 있는 상황이었고, 정해진 예산 안에서 높은 사양의 Ethereum Node를 2대 이상 추가로 구축하기는 어려웠습니다.
하지만 L1 RPC는 블록 생성, 즉 Layer2 네트워크의 Liveness에 직접적인 영향을 주는 영역입니다. 단순히 비용 문제만을 이유로 안정성을 포기하기도 어려웠습니다. 그래서 Dedicated Node는 한 대만 구축하되, 해당 노드에 장애가 발생했을 때 Alchemy로 자동 전환하는 Multi-Provider Failover Architecture를 제안하게 되었습니다.
Multi-Provider Failover 아키텍처
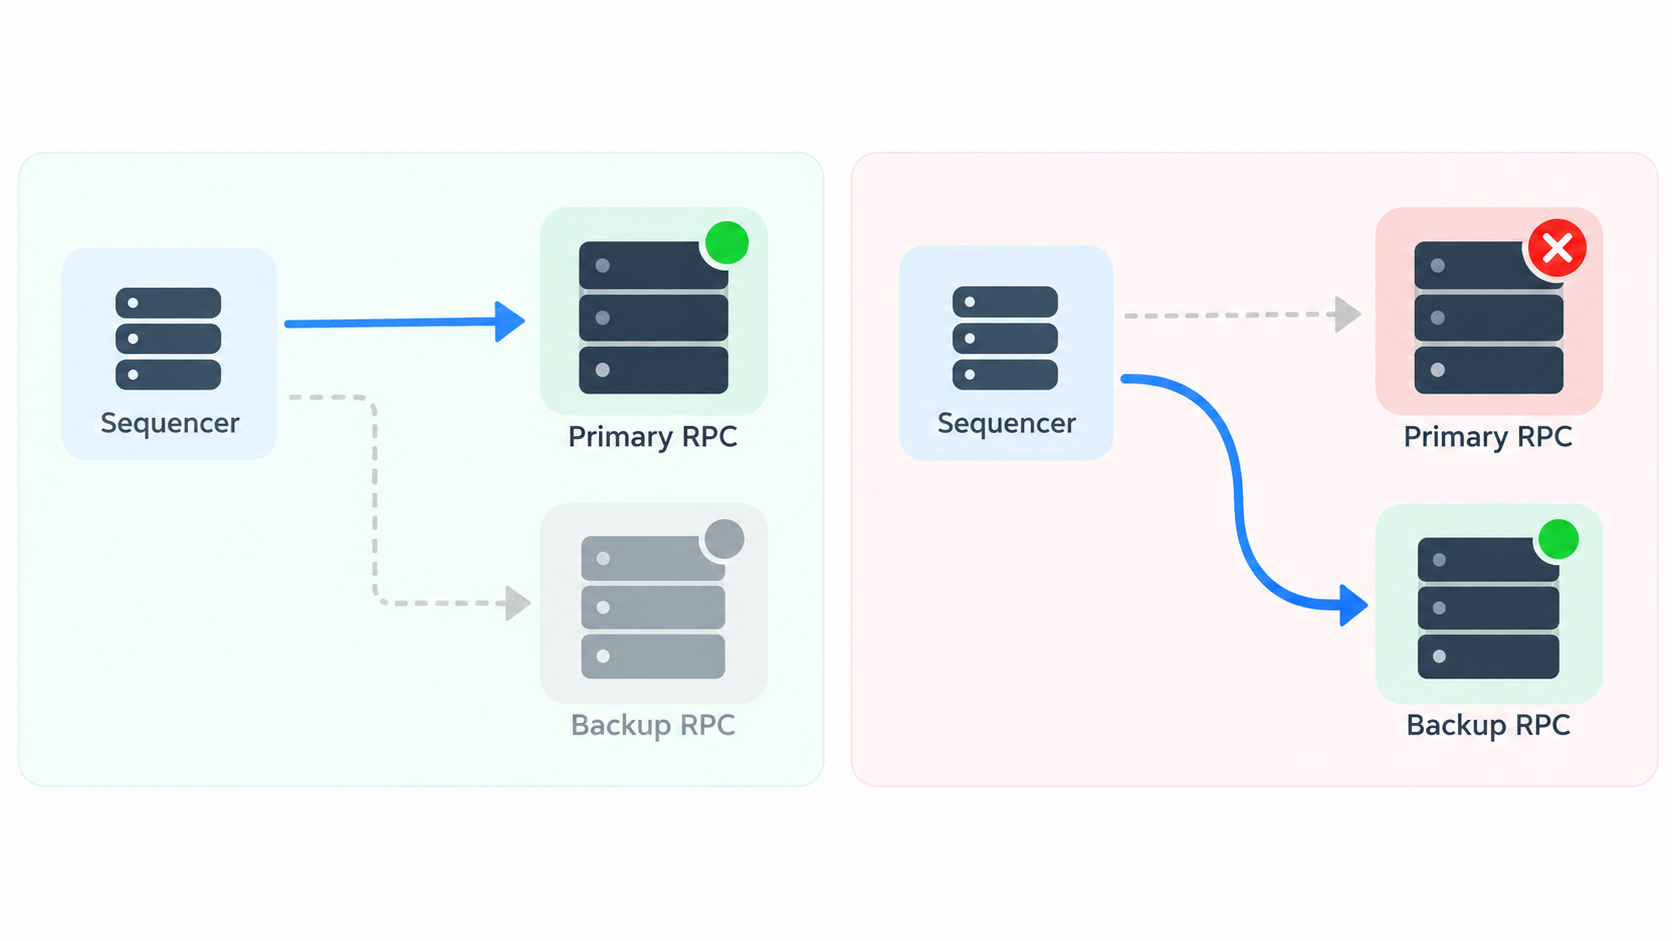
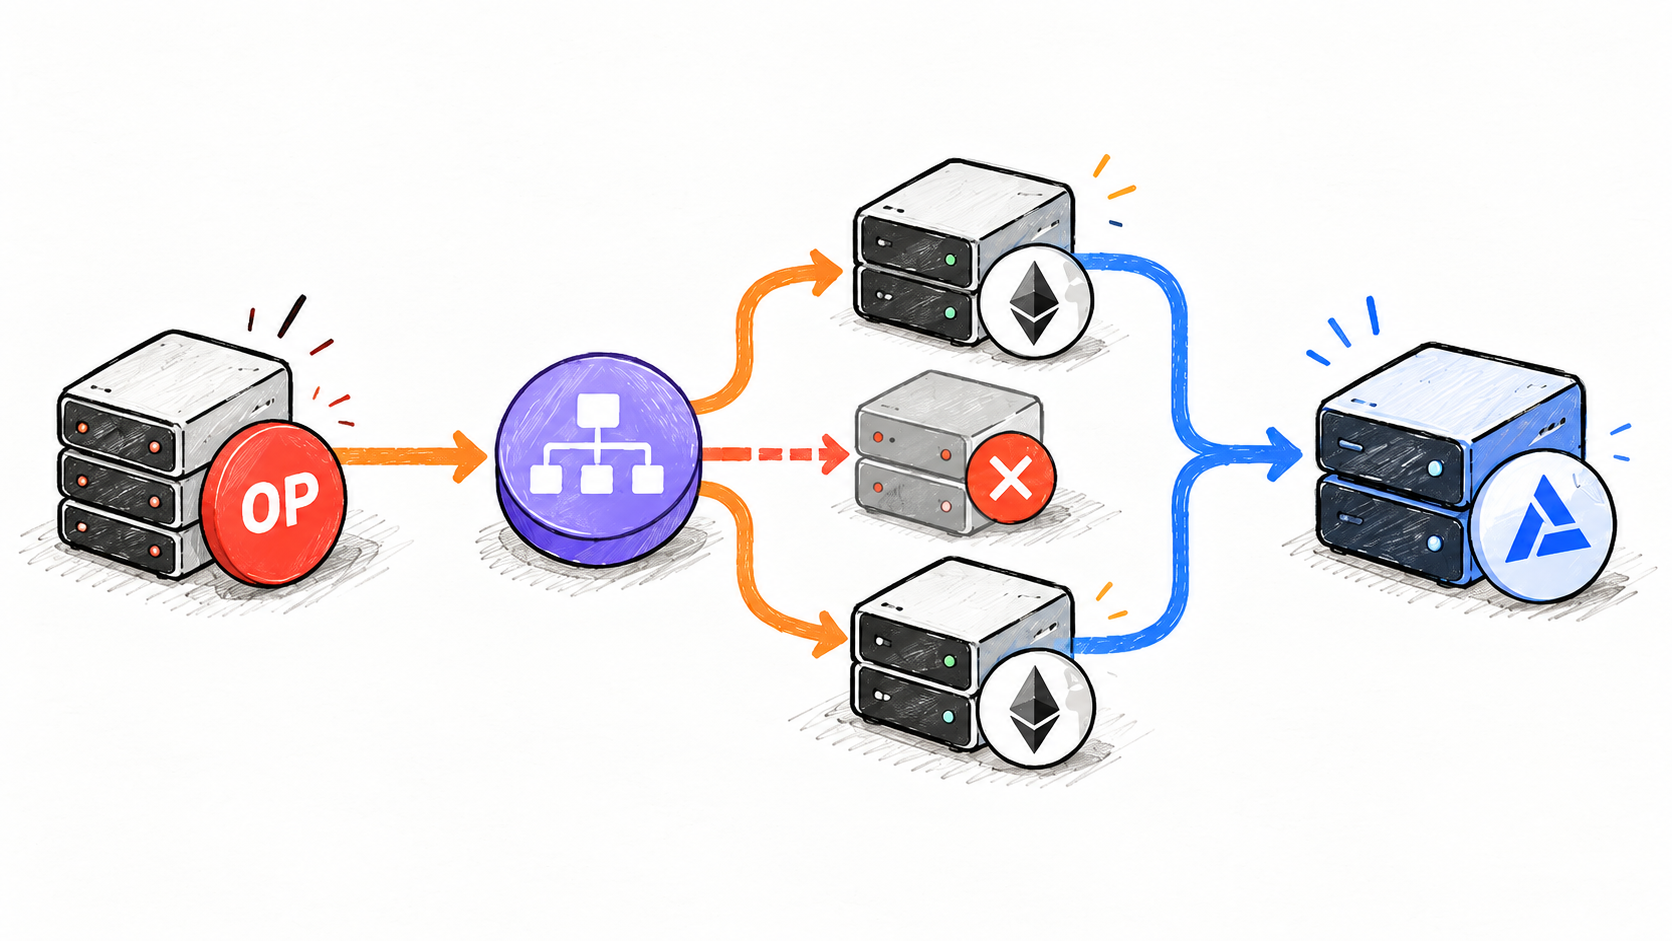
Multi-Provider Failover는 Primary RPC Node에 문제가 발생해 정상적으로 요청을 처리하지 못할 경우, 미리 준비된 다른 RPC Provider로 자동 전환하는 구조입니다. 직접 구축한 Ethereum Dedicated Node를 Primary로 두고, 평상시에는 Sequencer가 해당 노드를 통해 L1 정보를 조회하도록 구성했습니다. 그리고 Dedicated Node에 장애가 발생하거나 정상적인 RPC 응답을 제공하지 못하는 상황에서는 Alchemy RPC로 전환되도록 설계했습니다.
Alchemy는 사용량에 따라 비용이 발생하는 구조이기 때문에 평상시에는 사용하지 않고 Failover 상황에서만 사용한다면 비용 부담도 크게 줄일 수 있었습니다. 물론 Alchemy로 전환된 이후에는 이전에 경험했던 RPC 지연 문제가 다시 발생할 가능성이 있습니다. 하지만 이 구조에서 가장 중요하게 본 것은 성능보다 Liveness였습니다.
Layer2와 Sequencer를 운영하는 입장에서 가장 치명적인 상황은 Sequencer가 완전히 멈추는 것입니다. Sequencer의 블록 생성이 중단되면 단순히 네트워크 하나가 느려지는 문제가 아니라, 해당 체인 위에서 운영되는 결제와 정산을 포함한 모든 서비스가 영향을 받기 때문입니다. 따라서 일정 수준의 성능 저하를 감수하더라도 체인이 멈추지 않도록 만드는 것이 우선순위였습니다. 이러한 Provider 전환 정책과 Failover 기능은 eRPC 프록시를 활용해 구현했습니다.
eRPC — EVM RPC Proxy
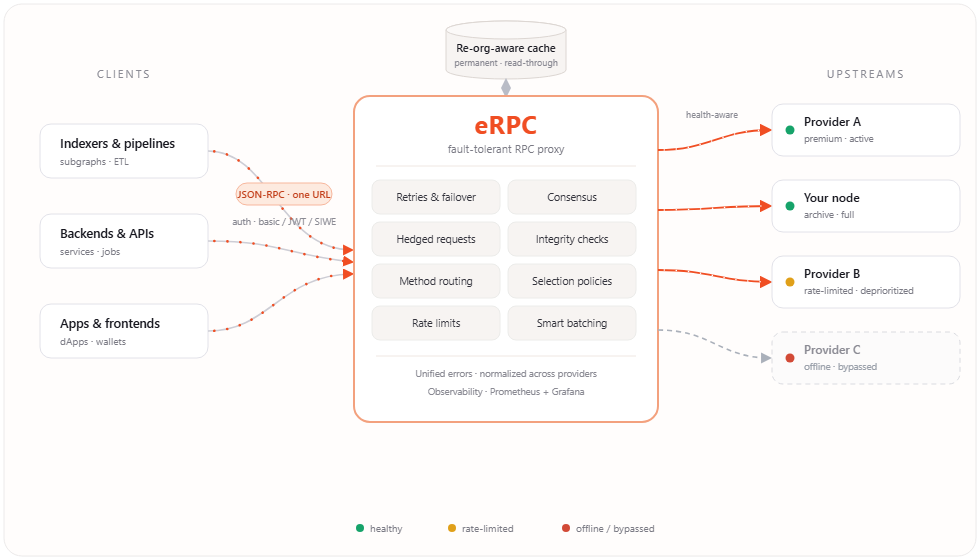
eRPC는 EVM RPC 트래픽에 특화된 Proxy입니다. 일반적인 Nginx나 Caddy가 HTTP 요청을 어떤 서버로 전달할지 판단한다면, eRPC는 여기서 한 단계 더 나아가 eth_call, eth_getLogs, eth_getBlockByNumber와 같은 Ethereum JSON-RPC 요청의 특성을 이해한 상태에서 트래픽을 라우팅합니다. 단순한 HTTP Load Balancing뿐만 아니라 Block Height, Finality, Reorg, Node Sync 상태와 같은 블록체인 특유의 상태를 고려할 수 있기 때문에 EVM RPC 환경에 특화된 Proxy로 사용할 수 있습니다.
특히 eRPC는 각 Upstream의 실제 오류율, 응답 지연 시간, Block Head 지연 등의 상태 데이터를 기반으로 주기적으로 점수를 계산하고 Upstream의 우선순위를 결정합니다. 상태가 좋지 않은 Provider는 우선순위에서 밀려나거나 요청 대상에서 제외되고, 정상적으로 응답하는 Provider가 우선적으로 선택됩니다.
이 기능을 활용해 직접 구축한 Dedicated Node를 Primary Upstream으로 지정하고, 해당 노드에 장애가 발생하거나 정상적인 RPC 응답을 제공하지 못할 경우 Alchemy로 Failover되도록 구성했습니다.
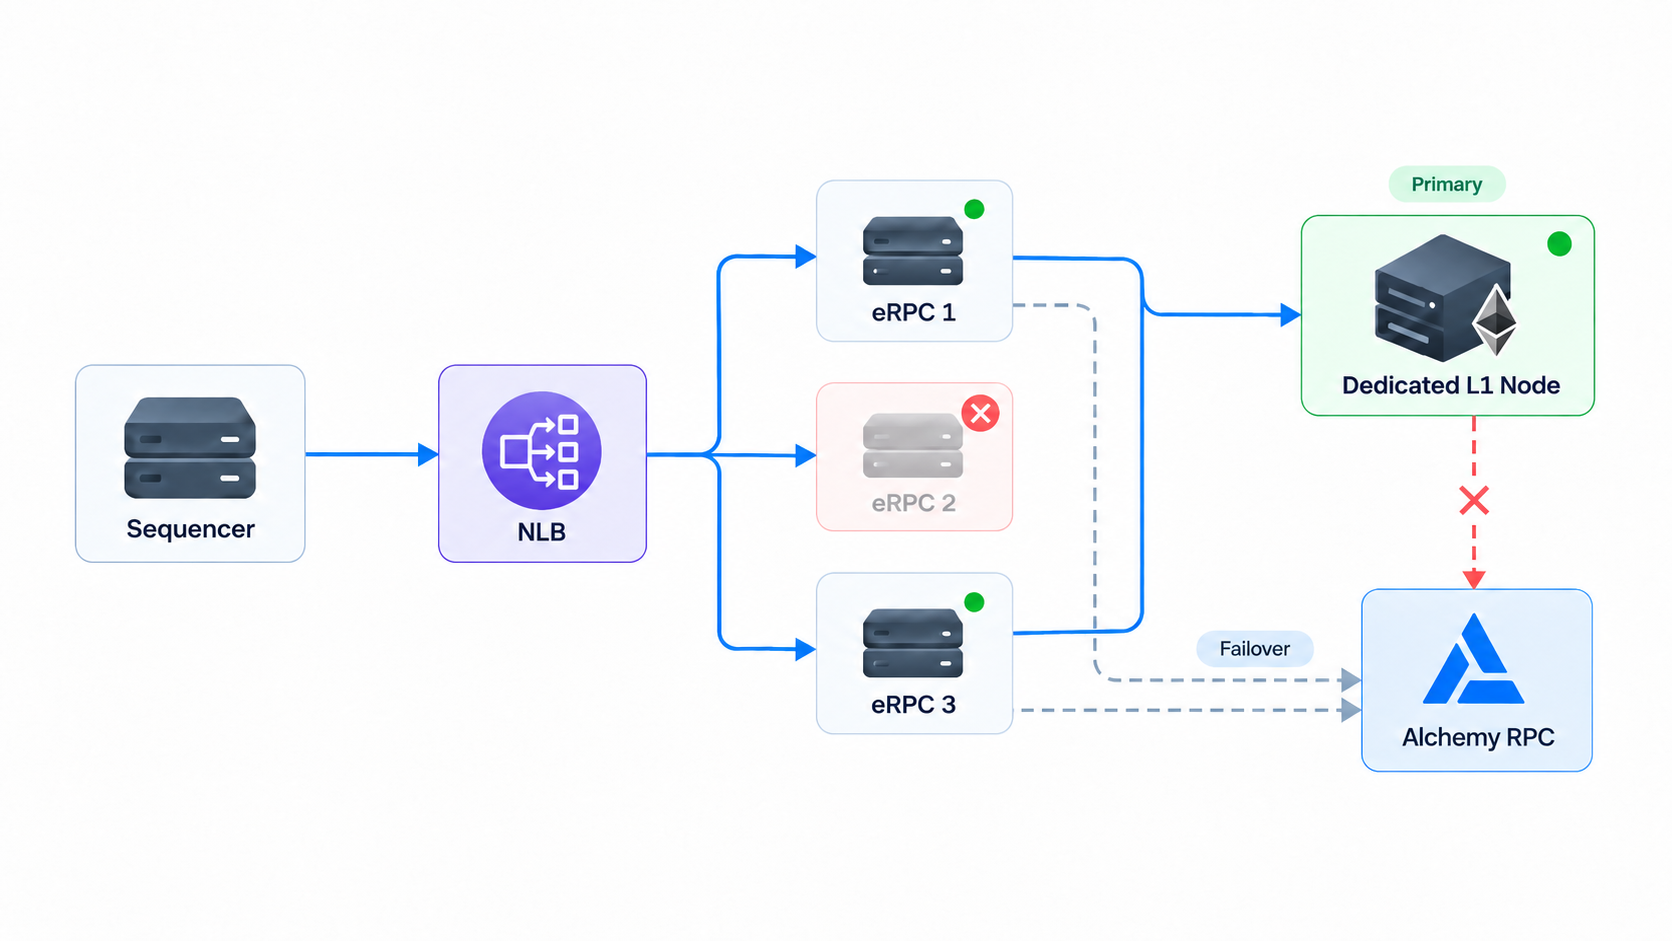
이 구조를 안정적으로 운영하기 위해서는 eRPC 계층 자체의 가용성도 함께 고려해야 했습니다. Dedicated Node와 Alchemy가 모두 정상적으로 동작하더라도 eRPC 인스턴스가 중단되면 Sequencer는 L1 네트워크 정보를 조회할 수 없기 때문입니다.
따라서 eRPC도 단일 인스턴스로 두지 않고 여러 대로 구성했으며, 앞단에 AWS NLB를 배치해 Load Balancing하도록 설계했습니다. 평상시에는 여러 eRPC 인스턴스에 트래픽을 분산하고, 특정 인스턴스에 문제가 발생하면 정상적인 다른 인스턴스가 요청을 대신 처리하도록 구성했습니다.
결과적으로 일부 eRPC 인스턴스에 장애가 발생하더라도 전체 인스턴스가 동시에 중단되지 않는 이상 Sequencer가 L1 RPC Provider에 계속 접근할 수 있도록 만들었습니다. 이를 통해 RPC Provider뿐만 아니라 Failover를 담당하는 Proxy 계층까지 이중화할 수 있었습니다.
마무리
Layer2 체인을 운영하는 입장에서 L1 통신 장애로 인해 Sequencer의 블록 생성이 지연되거나 중단되는 문제를 해결하기 위해 Multi-Provider Failover Architecture를 설계해봤습니다.
이번에 적용한 구조는 단순히 블록체인 네트워크에만 한정되는 방식은 아니라고 생각합니다. DApp이 여러 RPC Provider와 통신해야 하는 환경이나, 다수의 블록체인 노드를 운영하면서 특정 노드의 장애에 대비해야 하는 경우에도 충분히 활용할 수 있는 구조입니다.
블록체인 개발자로 일하면서 직접 겪었던 문제와 이를 해결하기 위해 고민했던 과정을 회고의 일부로 정리해봤는데요. 비슷한 환경에서 RPC 장애나 노드 이중화 문제를 고민하고 있는 분들에게 이 글이 조금이나마 참고가 되길 바라며 글을 마치겠습니다.